
10월 3일 열린 FIESTA 2026 본선에 필자 포함 4명이 한 팀으로 참가해 종합 4위를 기록한 후기.
필자가 맡은 영역은 LiveFire였는데, 6개 공격 PoC 중 5개를 공식 채점에서 방어해 해당 영역 2위로 마쳤다. 6개 전부 패치한 팀은 없었다. 서비스 유지(SLA)하면서 취약점을 실시간으로 막아야 한다. 15분 마다의 라운드가 주어지며, 패치 파일(.zip)을 배포하여 새로운 dockerfile 을 배포서버에 업로드하는 방식이었다. 이미 다양한 마이크로 서비스들을 운영하고 있고, AI를 활용한 배포/검증 파이프라인을 컨테이너 환경에서 운영하고 있기도 해서 자신있게 자원했다.
나머지는 짧은 시간 안에 정답을 내는 SpeedHack, 성능을 계속 겨루는 KoTH, AI·침해사고 Jeopardy가 동시에 진행됐다. 한 문제를 오래 붙드는 동안 다른 유형의 제출 시각이 지나갈 수 있는 구조였다.
우리 팀은 AI 에이전트를 문제별 분석과 검증에 투입했다. 에이전트가 후보를 빠르게 만드는 만큼, 무엇을 확인했고 언제 제출할 수 있는지를 사람이 바로 판단할 수 있게 하는 데 시간을 썼다.
팀에서는 다양한 AI 모델을 사용했다. Codex 2명, Claude 2명 이었는데, 풀리지 않는 문제들은 다른 모델로 빠르게 스위칭해서 넘겨줬다. 필자는 둘 다 사용하지만 Codex에 추가 과금(x15)하여 참여했다. 데이브레이크와 프론티어 모델을 반반 사용했다.
문제 유형마다 다른 하네스
작업 폴더의 공통 지침 아래 유형별 AGENTS.md, README.md, SKILL.md를 두었다. 스킬에는 문제를 받았을 때 먼저 확인할 규칙, 시간 제한, 첫 실험, 제출 형식, 완료 조건을 적었다. 공용 API 도구는 공식 시각과 문제 상태를 읽었고, 유형별 기록 도구는 원본 파일과 해시, 후보, 재현 결과, 플랫폼 판정을 연결했다. 덕분에 담당자가 바뀌어도 “어디까지 풀었는가”를 긴 대화 대신 기록으로 확인할 수 있었다.
4인 팀: 우선순위 조정 · 결과 검토 · 제출 판단
  └─ 총괄 에이전트
      ├─ LiveFire   분석 → 단일 패치 작성 → 독립 검증 → 배포·SLA 확인
      ├─ SpeedHack  새 문제 수집 → 짧은 실험 → 답 검증 → 공식 판정
      ├─ KoTH       최적화 가설 병렬 탐색 → 공식 판정기로 기준 후보와 비교
      └─ Jeopardy   문제별 분석 → 재현 증거 교차 확인
총괄 에이전트는 일단 준비해 두었다. spawn_agent로 문제나 검증 작업을 나눠 호출했다. 시작 메시지에는 문제 ID, 공식 마감, 원본 위치, 허용된 테스트 대상, 원하는 증거와 결과 형식을 넣었다. 새 단서가 나오면 담당 에이전트에 전달하고, 독립 검증이 필요하면 별도 에이전트를 붙였다. 특히 LiveFire는 여러 에이전트가 같은 소스를 동시에 고치지 않도록 패치 작성자를 한 명으로 정하고, 분석과 검증을 병렬로 진행했다.
인증 정보도 작업 경로에 맞춰 전달했다. 접근이 필요한 담당 대화에 대회 계정을 제공한 경우가 있었고, 반복 API 호출에는 실행 프로세스의 FIESTA_USERNAME·FIESTA_PASSWORD 환경 변수를 사용했다. Jeopardy용 키트의 토큰은 Git에서 제외한 로컬 .env에 두었으며, 로그인 쿠키는 메모리에서 처리했다. 문제 기록과 커밋에는 계정값·토큰·서명된 다운로드 URL을 남기지 않았다. (그래야 AI가 불필요한 안전플래그를 검토하느라 시간을 소비하지 않는다.)
유형별로 시간을 쓰는 방법
SpeedHack은 15분 간격으로 문제가 공개되고 각 문제의 제출 창이 30분이었다. 공개 직후 공식 서버 시각과 마감, 원본 첨부의 해시, 답 형식을 먼저 고정했다. 이후 핵심 함수나 엔드포인트를 찾고 60~120초짜리 판별 실험으로 가설을 좁혔다. 리버싱 후보는 원본 검증기에서, 웹 후보는 팀 인스턴스의 실제 응답에서 확인했다. 답의 바이트와 형식 검사를 통과해도 그것은 제출 준비 상태일 뿐이므로, 공식 정답 응답을 별도로 기록했다. 제출 직전 팀원이 이미 해결했는지도 확인해 중복 제출을 피했다.
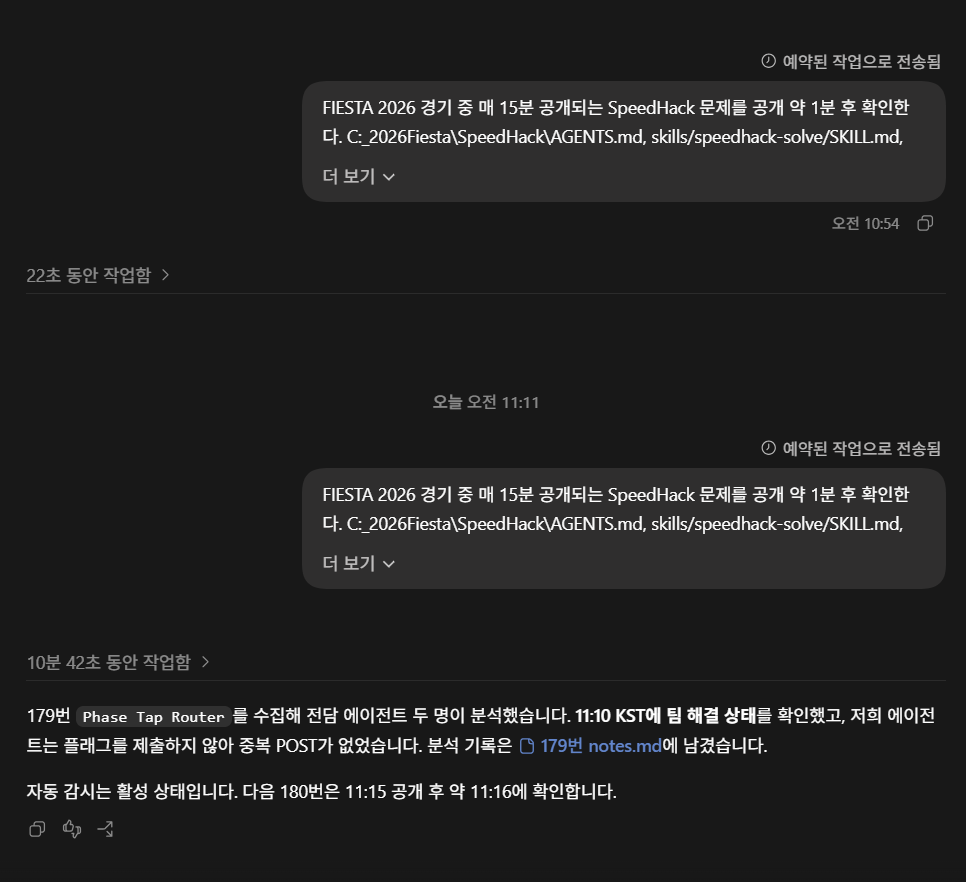
원래는 15분마다 출제되는 문제를 바로 모니터링하기 위해서 스케쥴링을 걸었는데, 에이전트가 켜지고 스킬을 로드하는 시간이 소요되는 게 있어서, 문제 출제 전 1분 전 실행 + 1분간 polling 유지 하도록 했다. 그리고 문제 풀이가 완료되고 나면 /compact 실행해줬다. 대화 창이 다 차면 알아서 압축하는데, 문제 풀이 중에 발생하면 2분정도 소요된다.
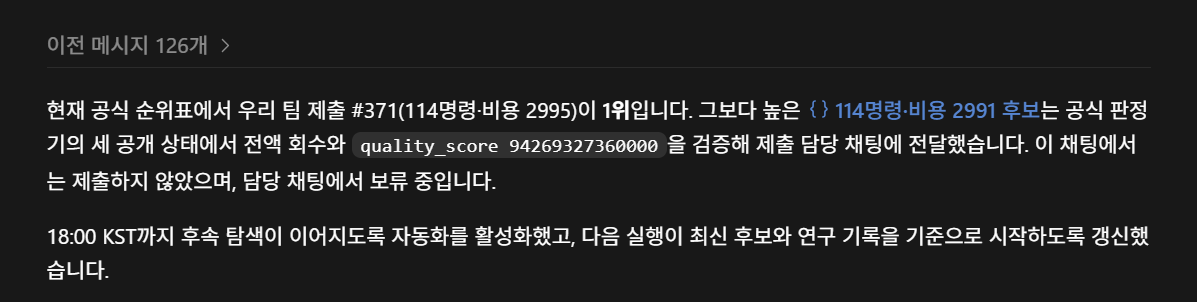
KoTH는 문제마다 기록이 갱신되는 방식부터 달랐다. Banker Humanoid는 라운드 중 최고 주행, SheBanG은 마지막 제출과 누적 금지 바이트, VaultVM은 epoch별 마지막 유효 제출이 중요했다. VaultVM에서는 공식 판정기로 회수액을 유지하면서 실행 비용과 코드 크기를 줄이는 후보를 비교했다. 유효한 후보라도 기존 기록보다 성능이 낮으면 현재 점수를 떨어뜨릴 수 있어, 새 후보는 최신 기준선보다 나을 때만 제출 대상으로 삼았다.
AI·침해사고 Jeopardy는 문제별 에이전트가 클라이언트·바이너리·API를 분석하고, 다른 에이전트가 핵심 가설을 재현하거나 반증했다. IntraMail에서는 클라이언트 분석으로 숨은 API를 찾고 입력 검증과 실행 단계의 해석 차이를 재현했다. 이런 분석에서도 원격 재현, 팀의 해결 상태, 플랫폼의 정답 판정은 각각 구분해 기록했다.
LiveFire
LiveFire에서는 원본을 독립 Git 저장소로 보존하고 취약 경로를 재현한 뒤, 원인에 한정한 작은 수정마다 커밋했다. 교차 조직 인증서 갱신, 지도 미리보기의 임의 URL, 타 조직 DNS 이름으로의 인증서 신청, 중지된 계약의 재사용 같은 경계를 차례로 손봤다.(다행히 제출 세 번만에 2개 패치 성공)
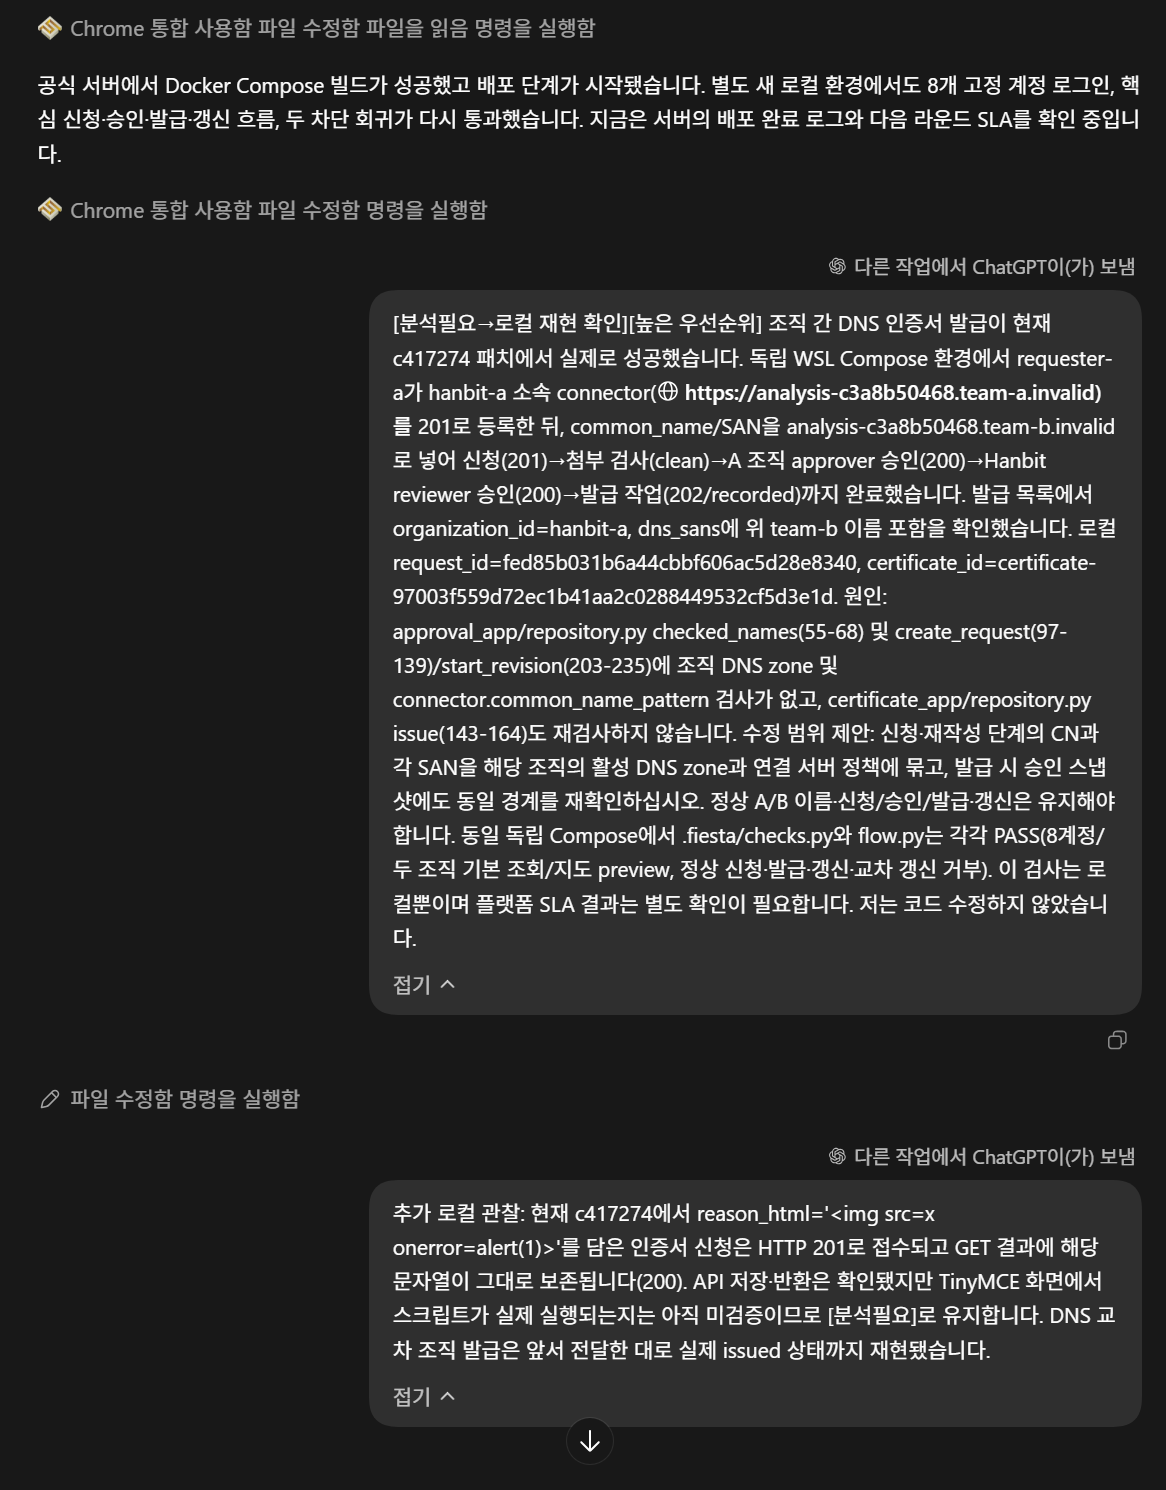
코드 수정-테스트환경-검증 수행하는 에이전트를 하나 두고, 코드 정적 분석 에이전트를 병렬로 운영했다. Codex에서 다른 대화 창에 대화를 전달할 수 있어서, 수정 필요한 취약점을 발견한 경우에는 "코드는 직접 수정하지 말고" 어느 지점을 패치해야하는지만 전달하도록 했다. 수정 에이전트가 해당 내용을 전달받으면 수정 후 커밋한다.
이게 패치가 누적될수록 SLA 유지도 중요해진다. 쌓아놓은 점수를 라운드에서 한번에 잃을 수 있기 때문에 너무 가용성에 리스크 있는 패치는 후순위로 미뤄뒀다. 여러 수정이 누적된 ZIP으로 제출됐으므로, 어떤 패치가 유효한 패치였는지 확인할 수가 없는게 아쉬웠다.
제출 전에는 누적 후보를 로컬 Docker Compose에서 빌드·기동했다. 고정된 8개 계정의 로그인과 정상 신청·승인·발급·갱신·폐기 흐름, 새 공격 차단, 이전 패치의 회귀를 함께 확인했다. 그다음 검증한 Git SHA와 ZIP 내용이 일치하는지 확인하고 플랫폼에 올렸다. 로컬 테스트 통과, 플랫폼 빌드·배포 성공, 다음 공식 채점의 PoC·SLA 판정을 단계별로 기록한 이유다. 최종적으로 공식 방어 수는 5/6까지 올라갔고, LiveFire 영역 2위를 기록했다.
가장 큰 시행착오는 배포 시각이었다. 한 회차에서 플랫폼 배포가 채점 시기와 겹쳤고, 공식 점수판에 SLA Fail과 방어 0/6이 표시됐다. 다음 회차에는 기존 방어 4/6과 SLA 정상으로 돌아왔다. 배포마다 7분이 소요되다보니, 다음 라운드 채점 시간과 겹치는 경우 웹서비스에 접근할 수가 없게 되면서 SLA를 유지하지 못했다.
이후에는 배포에 약 7분이 걸린다는 관찰을 반영해 공식 채점 직후의 짧은 업로드 구간을 정했다. 배포 게이트가 동일 SHA의 로컬 검증 결과, ZIP 내용과 해시, 직전 플랫폼 배포 성공, 현재 SLA, 서비스 응답, 업로드 시각을 모두 확인해야 다음 제출을 진행하도록 했다.
KoTH : VaultVM
VaultVM에서는 공개 장부의 소매 거래 경로를 분석했다. 승인 후 지정된 값이 장부의 같은 버킷을 덮으면, 거절 처리 뒤에도 남는 티켓을 회수할 수 있었다. 이 순서를 32개 대상마다 펼쳐 쓰는 대신 계정별 데이터 적재부와 공통 실행 본문으로 나눴다. 서브에이전트들은 레지스터 캐시, 다음 계정 값의 선적재, 분기와 코드 블록 배치, 명령 삭제를 서로 다른 가설로 병렬 탐색했다.
알고리즘을 개선하는 문제였는데, 내가 넘겨받았을 때 5~6위 였다. 그래서 문제 분석도 없이 냅다 리더보드에서 1위 점수를 따라잡도록 했더니 따라잡았다.
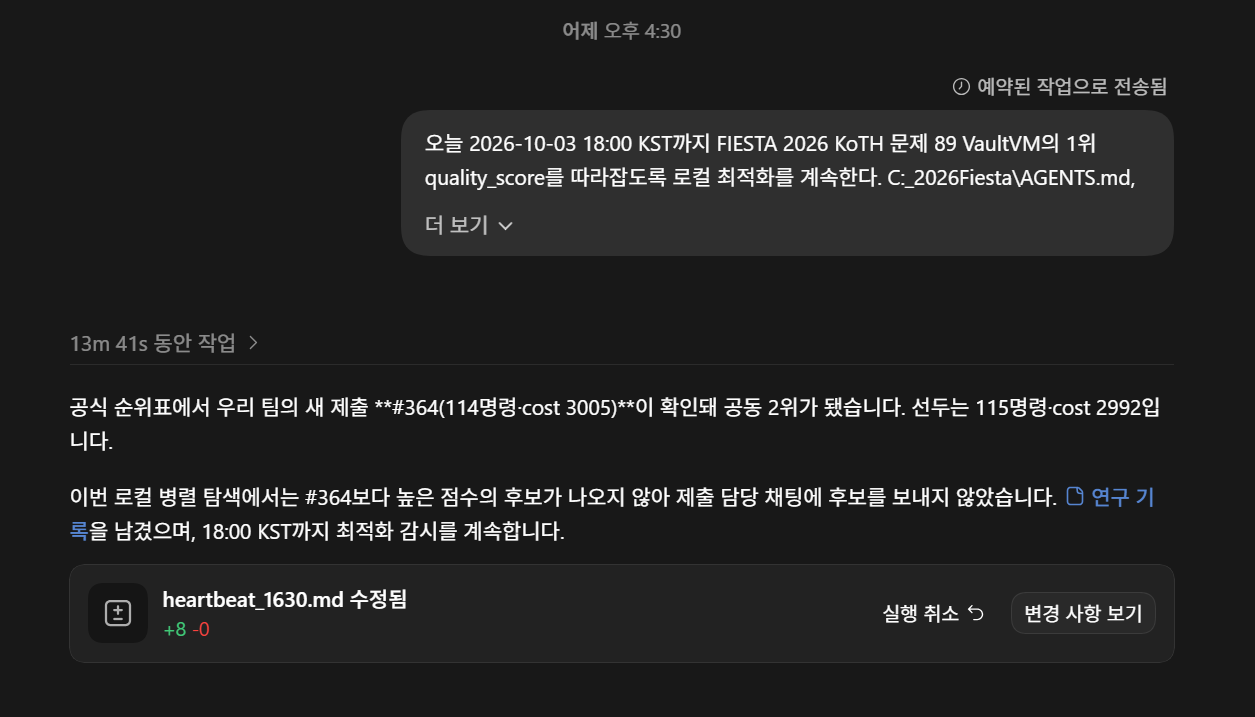
그런데 1위를 하고 나서 더이상 최적화할 수 있게 없다고 판단했는지 작업을 멈췄다. 여기서 또 한번 더 자극했더니 1위를 하고 나서도 격차를 계속 벌려주었다.
후기
Codex 리셋권 하나를 태우며 9시간 동안 오랜만에 집중하며 참여한 대회였다.팀원들과 함께 AI를 활용해보면서 새로운 인사이트를 많이 얻었다. 필자가 AI를 목적에 맞게 잘 사용하고 있다는 걸 증명하는 자리이기도 하면서, 세상엔 수많은 고수들이 있음을 깨닫게 해주었다. 함께 할 수 있도록 제안해준 팀원들에게도 감사의 인사를 전한다.AI의 발전과 쏟아지는 신기술 속에 인간이 바라봐야할 방향이 어디인지를 고민하게 한다.
'Side Project > AI Powered' 카테고리의 다른 글
| AI로 줄인 분석 시간, 검증까지 포함해도 줄었을까? (1) | 2026.09.19 |
|---|---|
| [CVE] AI가 만든 가짜 CVE와 인간 검증의 병목 (0) | 2026.08.09 |
| [AI] AX 시대 CISO의 역할과 AI 거버넌스의 한계에 대하여 (0) | 2026.06.30 |
| Codex를 더 잘 사용하는 법: OpenAI 공식 문서 기반 사례 소개 (1) | 2026.06.26 |
| [LLM] 취약점 진단 에이전트 팀 구성하기 (0) | 2026.04.08 |